A estas alturas, pocos son quienes no han oído hablar de la inteligencia artificial y de su capacidad para transformar innumerables campos, incluidas las humanidades. Los modelos de lenguaje modernos como GPT, tras entrenarse con grandes cantidades de ejemplos, logran generar respuestas muy similares a las humanas. Es en este contexto en el que la IA generativa se ha adentrado en la epigrafía, el estudio de textos inscritos en materiales duraderos, para ofrecer una nueva herramienta que ayude a rellenar los huecos que el paso de los años ha creado entre el presente y el pasado.
La historia humana nace en la escritura. Sin embargo, el paso del tiempo impone desafíos monumentales: daños en las inscripciones, falta de fechas explícitas y la posible aparición de los textos en ubicaciones que no coinciden con su lugar original, a veces perdido. La tarea crucial de los expertos, conocida como contextualización, consiste en identificar textos paralelos —inscripciones con frases o funciones compartidas— para poder restaurar el texto perdido y asignarle un origen geográfico y cronológico potencial. Hablamos de un proceso eminentemente laborioso, altamente especializado y, a menudo, limitado por búsquedas manuales o por técnicas simples de coincidencia de cadenas de texto. Para atajar estas limitaciones, se han desarrollado dos modelos pioneros: Ithaca y su sucesor, Aeneas.
La aplicación de redes neuronales a la epigrafía antigua
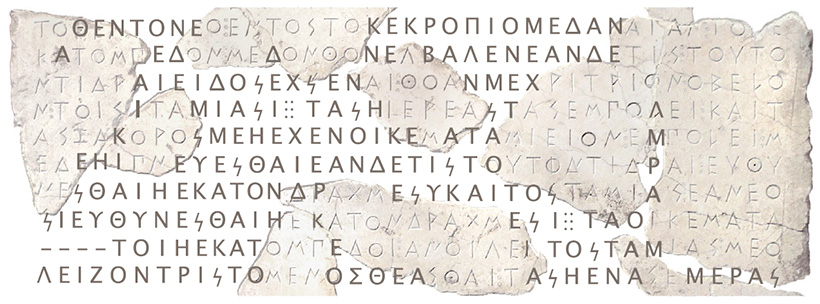
El proyecto para llevar la inteligencia artificial a la epigrafía fue iniciado en marzo de 2022 por Yannis Assael, Thea Sommerschield y un equipo multidisciplinar. De su esfuerzo combinado surge Ithaca, una red neuronal profunda lanzada para asistir en la contextualización de inscripciones en griego antiguo. La idea original buscaba realizar simultáneamente las tres tareas centrales de la epigrafía: la restauración de texto, la atribución geográfica y la atribución cronológica.
Para entrenar a Ithaca, se construyó el conjunto de datos I.PHI, conformado por 78 608 inscripciones a partir del corpus del Packard Humanities Institute (PHI). Este corpus abarca el mundo mediterráneo antiguo, desde el siglo VII a. C. hasta el siglo V d. C.
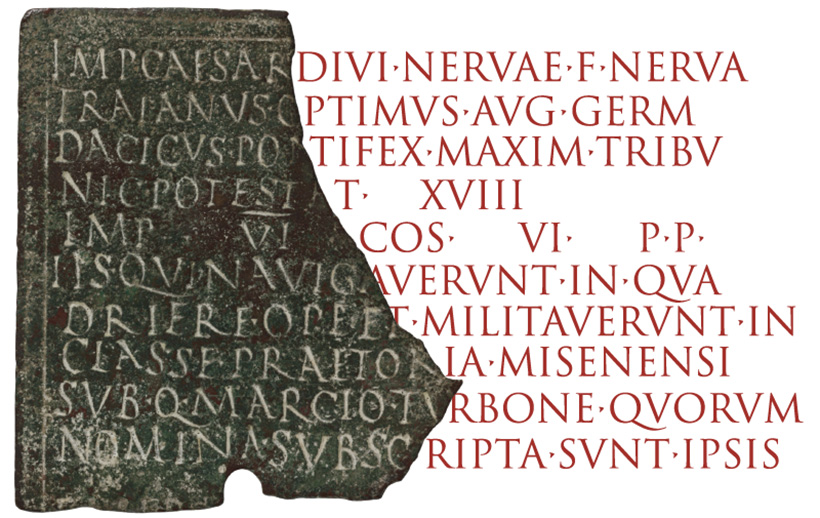
Construyendo sobre el impulso de Ithaca, el mismo equipo lanzó Aeneas en 2025. Aeneas, llamado así por el héroe mítico que buscó dónde fundar la futura ciudad de Roma, se enfoca en las inscripciones en latín.
Para que Aeneas aprendiera los patrones lingüísticos e históricos del latín epigráfico, se construyó el Latin Epigraphic Dataset (LED), combinando múltiples bases de datos masivas. Este corpus final abarca más de 175 000 inscripciones con más de dieciséis millones de caracteres, y cubre desde el siglo VII a. C. hasta el siglo VIII d. C. Aun con todo, este tamaño es significativamente más reducido que los conjuntos de datos usados habitualmente en el procesado de lenguaje natural contemporáneo.
Los modelos de IA dependen de la calidad y cantidad de los datos para aprender y generalizar. El curado de datos fue un desafío complejo en ambos proyectos, ya que se requería estandarizar una gran cantidad de información proveniente de distintas fuentes. A pesar de lo laborioso de esta etapa, es aquí donde se produce una parte fundamental del valor: contar con información y formatos consistentes resulta clave para facilitar a los modelos una tarea ya de por sí compleja. Por ejemplo, en el caso de Aeneas, se decidió retener las restauraciones conjeturales, es decir, el texto que los editores humanos previamente habían insertado entre corchetes. Esta decisión, a pesar del riesgo de perpetuar sesgos existentes, permite aprovechar la mayor cantidad de información posible en un entorno donde los modelos de deep learning se benefician enormemente de grandes volúmenes de datos, pero estos escasean.
La hidra tricéfala: restauración, localización y datación
Ambos modelos, Ithaca y Aeneas, están entrenados para abordar las tres tareas fundamentales de la epigrafía:
1. Restauración de texto: reconstruir partes faltantes del texto dañado.
2. Atribución geográfica: predecir la región o provincia de origen. Ithaca clasifica la inscripción entre ochenta y cuatro regiones antiguas, mientras que Aeneas predice entre sesenta y dos provincias romanas.
3. Atribución cronológica: estimar la fecha de escritura, asignando una distribución en décadas. Ambos modelos discretizan las fechas en rangos de diez años, abarcando desde el 800 a. C. hasta el 800 d. C. en el caso de Ithaca.
Aeneas, al ser el modelo más reciente, introdujo ciertas mejoras clave sobre Ithaca:
-Restauración de textos con longitud desconocida: Ithaca, en su evaluación inicial, se centró en restaurar segmentos de longitud conocida (entre uno y diez caracteres). Aeneas evolucionó para convertirse en el primer modelo en generar restauraciones de texto antiguo de longitud arbitraria. Si la longitud exacta del texto faltante se desconoce, utiliza un carácter especial para identificar esta laguna.
-Multimodalidad: Aeneas integra tanto la transcripción textual como las imágenes de la inscripción como input a la hora de determinar el origen geográfico.
Ambos modelos utilizan arquitecturas basadas en transformer, un tipo de red neuronal que, a través de un mecanismo de atención, puede ponderar la influencia de diferentes partes del texto de entrada para tomar decisiones. Ambos modelos procesan todos los datos disponibles a través de su representación numérica, los embeddings, a partir de los cuales producen predicciones sobre el texto, la fecha y el lugar de origen de la inscripción a la vez. Además, proporcionan mapas de características que muestran a qué partes de la frase se presta mayor atención a la hora de generar la predicción.
La IA como acompañante: resultados de una sinergia
El principio fundamental demostrado por ambos proyectos es que la colaboración (humano + IA) supera el rendimiento individual. La IA funciona como una herramienta que alivia la naturaleza laboriosa de la epigrafía, permitiendo a los historiadores concentrarse en la interpretación crítica y en la aportación de conocimiento externo.
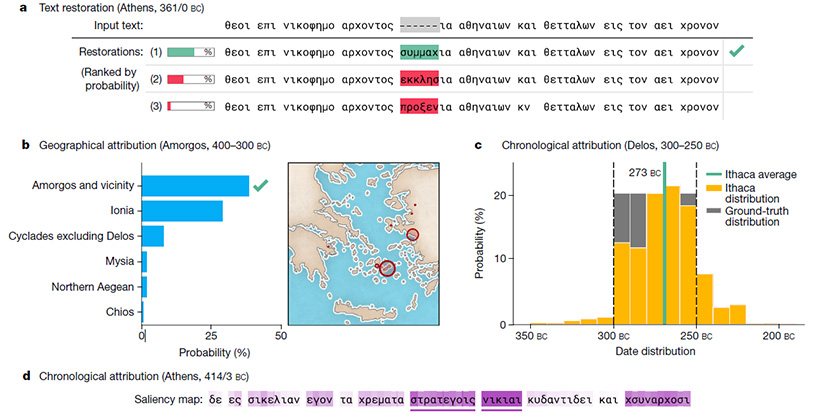
Para medir el impacto de la colaboración humano-IA, para Ithaca se seleccionaron múltiples inscripciones a las que se les ocultó una secuencia de entre uno y diez caracteres. A continuación, se les pidió a los historiadores y al modelo que propusieran tres posibles restauraciones, ordenadas por probabilidad. Seguidamente, se pidió a los historiadores que formularan sus hipótesis apoyándose en los resultados de Ithaca.
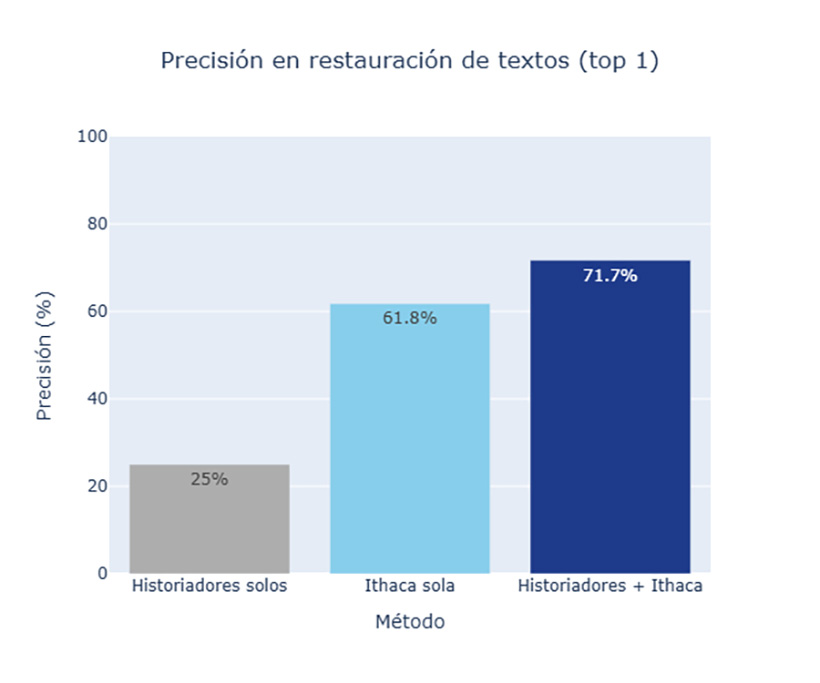
Con esta metodología, cuando los historiadores trabajaron sin ayuda lograron acertar con su restauración más probable en un 25 % de los casos. Por su parte, Ithaca sola logró una precisión del 61,8 %. Sin embargo, cuando los historiadores podían apoyarse en los resultados del modelo, la precisión se disparó al 71,7 %, casi triplicando el rendimiento humano en aislado. Además, el modelo fue capaz de identificar correctamente el lugar de origen de las inscripciones en un 70 % si consideramos solo la primera predicción y en un 82 % si utilizamos las tres primeras. Por último, para la datación, Ithaca apenas se distanciaba veintinueve años de media de las fechas reales.
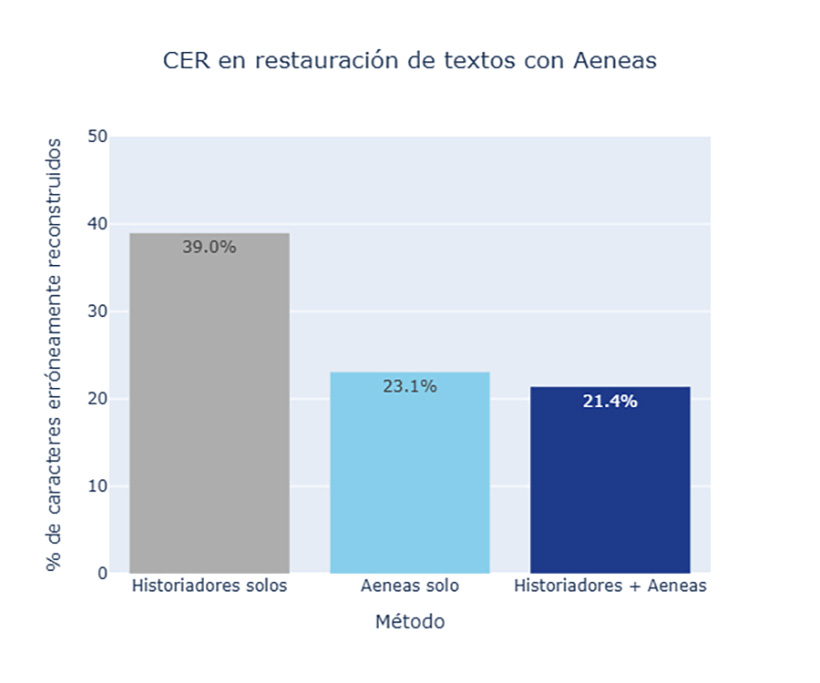
En el caso de Aeneas, la sinergia fue aún más acentuada: a la hora de medir el porcentaje de caracteres erróneamente reconstruidos (CER), los historiadores por sí solos alcanzaron el 39 %. Por su parte, Aeneas por sí solo logró un CER del 23,1 %. Sin embargo, cuando los historiadores se apoyaron en las predicciones de Aeneas, el error se redujo al 21,4 %, superando así la capacidad del modelo en solitario.
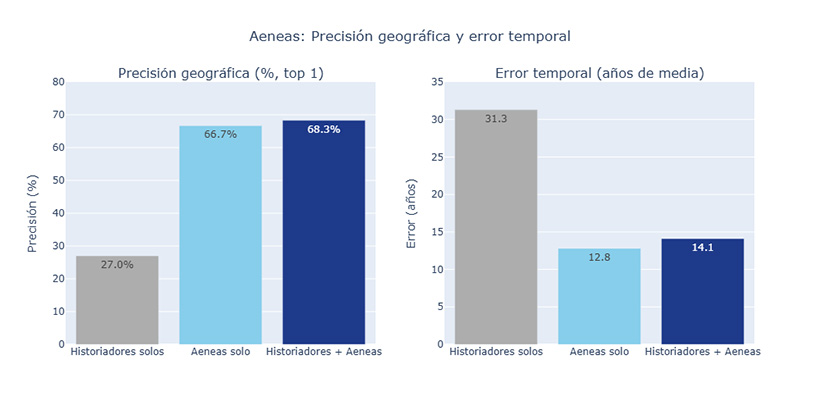
En cuanto a la atribución geográfica, los historiadores solos alcanzaron una precisión top 1 del 27,0 %; Aeneas, del 66,7 %, y, al trabajar juntos, un 68,3 %. Curiosamente, en la datación cronológica, Aeneas apenas se distanciaba 12,8 años de media de las fechas reales, cuando los historiadores en solitario erraban por 31,3 años de media, pero ni apoyándose en las sugerencias de Aeneas fueron capaces de batir al modelo, con un margen de 14,1 años de media.
Un acelerador de la investigación
Tal y como prometía la idea inicial, el enfoque de ambos modelos es ser una herramienta de apoyo que alivia la naturaleza laboriosa de la epigrafía. Los historiadores que participaron en la evaluación de Aeneas confirmaron que los paralelos generados por el modelo sirvieron como puntos de partida útiles para la investigación en el 90 % de los casos. En palabras de los expertos: «Encontrar estos textos me habría tomado un par de días en lugar de quince minutos».
Como un coche que acelera el proceso de movimiento pero no sustituye el andar, estos modelos son herramientas que complementan a los humanos. Ithaca y Aeneas encarnan este principio al fusionar la capacidad de cómputo con la crítica humanística. Además de publicar los artículos originales y subir el código utilizado en GitHub, el equipo de desarrollo ha puesto a disposición del público ambas herramientas para que cualquier interesado pueda experimentar con el estudio de textos antiguos en la web https://predictingthepast.com.